BAT新旗艦殺回第一陣營,壓力來到字節這邊
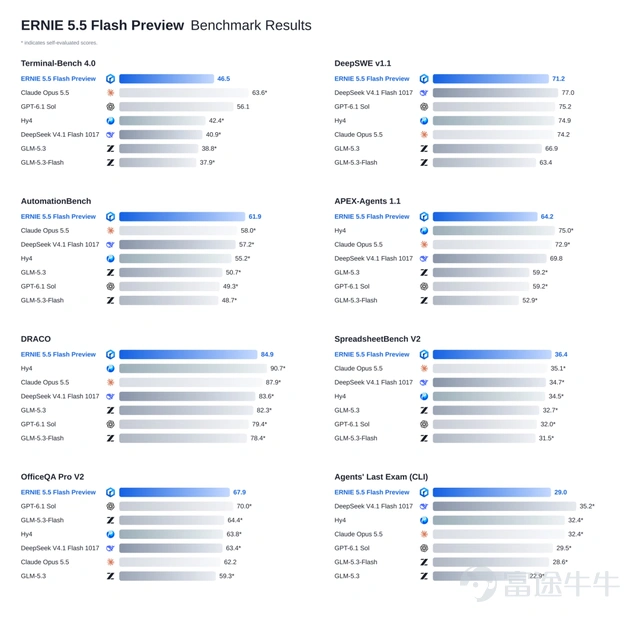
11月11日,沉寂許久的百度文心突然曬出一張成績單。
模型是ERNIE 5.5 Flash Preview,一共八項基準測試,對照組是Claude Opus 5.5、GPT-6.1 Sol、騰訊的Hy4、DeepSeek V4.1 Flash和智譜的GLM-5.3系列。八項裏,它拿了兩項第一。
這是文心一週之內的第三個動作。
11月5日,開源基座模型文心5.5 Flash Base;11月9日,披露自動研究系統ERNIE Evolve;11月11日,發佈 Preview。
並且將近一年沒更新的百度文心公衆號,也在這幾天恢復更新了。
同一段時間內,阿里也開放了Qwen4-Max預覽版。
再往前一週的11月4日,騰訊發佈Hy4正式版,在Artificial Analysis的智能指數V5榜單中拿到了35分,排中國模型第二。
互聯網時代的BAT御三家,又上桌了。
隨着大模型逐漸步入人們的生活,DeepSeek、月之暗面、智譜逐漸掌握了敘事權。BAT中的B,也被換成了字節跳動(ByteDance)。
說到字節,Seed系列的最新一代,仍是6月23日發佈的 Seed2.1。
8月的時候外媒曾報道過,Seed團隊正在預訓練一個參數規模最高可達10萬億的模型。三個月過去,這個模型沒有名字,沒有發佈日期,也沒有一張成績單。
11月12日,澎湃新聞從多方知情人士處獲悉,張一鳴在近期一次面向 AI 團隊的全員會上說,字節有能力與OpenAI和Anthropic競爭,但真正追平前沿技術,「最早也要到2029年或2030年」。
BAT 真的回來了嗎?張一鳴的10萬億模型又去哪了?
01
BAT 是怎麼回來的?
今年2月的LMArena綜合榜單上,文心5.0排在第17位,前面是字節Seed 2.0、智譜GLM-5、Qwen3.5。
那段時間百度的基礎模型團隊把大量精力投在創意寫作上,內部一度喊出打造「最強文科生」的口號,而同期的對手們卷的是編程、長上下文和Agent。
8月18日,百度發佈二季度業績,歸屬於百度的淨利潤23.19億元,同比下滑68%,美股當晚跌了12.73%。電話會上,李彥宏說:「一路走來,過程中有嘗試也有失誤,但是我們要讓文心具備競爭力的決心從未動搖。」他還說,有信心讓文心「重新回到基礎大模型的第一梯隊」。
「重新回到」四個字,等於承認了已經不在。
轉折發生在7月1日。
1997年出生的復旦博士孫天祥空降百度,出任基礎模型研發部負責人。他是國產初代類 ChatGPT 開源大模型 MOSS 的主導者。按《深網》的說法,這已經是百度模型線近十個月裏的第三輪大調整。
四個月後,文心開始連續出牌。
先是文心5.5 Flash Base,總參數280B,每個 token 激活14B,在33.5萬億 token 上從零預訓練。百度拿它和 DeepSeek-V4-Flash-Base、騰訊的 Hy3-preview-Base、小米的 MiMo-V2.5-Base 放進同一套框架裏測,30項基準裏有24項第一。這也是百度時隔約16個月,再次開源千億參數級的模型。
Preview是它的第一個後訓練版本。
AutomationBench 61.9分,SpreadsheetBench V2 36.4分,兩項第一,都排在Claude Opus 5.5前面;OfficeQA Pro V2 67.9分,僅次於GPT-6.1 Sol;Terminal-Bench 4.0是46.5分,高於Hy4的42.4分,離Claude Opus 5.5的63.6分還差着一截。
DeepSWE和Agents‘ Last Exam兩項,它在七個模型裏排第五。
圖上還有一行腳註:帶星號的是百度自測的分數。對手的成績,大半帶着星號。
百度自己的措辭是「取得了具有競爭力的得分」,還提醒這是後訓練過程中的一箇中間版本,「仍可能存在部分因訓練不充分導致的能力缺陷」。
但有兩件事是實打實的。一是又快又便宜,千帆上單用戶推理速度超過每秒200個 token,每百萬 token 忙時輸入2元、輸出8元,眼下還打五折。二是開源,權重將在11月25日前以 Apache 2.0協議放出。2024年,李彥宏說過開源模型會越來越落後。
再說阿里。
11月11日上午10點,阿里放出了Qwen4-Max預覽版,沒有價格,沒有參數量,也沒有跑分。
同一個文檔頁上還寫着:11月25日24點之後,這個模型退役,期間不做任何更改。不用想,阿里就是明擺着告訴你Qwen4-Max正式版於11月26日發佈。
預熱用的是《逍遙遊》:「北冥有魚,其名爲__。」原文接下去是「鯤之大,不知其幾千裏也」。
能確認的規格只有幾項,項項都在說大。最大輸出393216個 token,思考和答案共用,正好是上一代Qwen3.8-Max的三倍。思考強度分三檔,默認 xhigh,出廠就是想到最久。
而且Qwen4-Max只走Token Plan訂閱,不支持按量付費。
Qwen4-Max給人的感覺是「一力破萬法」,其預覽版的邏輯就是如此,只要模型的參數量和智能水平足夠高,那這個模型就一定好用。
但Qwen的力氣並不是堆出來的,而是省出來的。
9月22日雲棲大會,劉大一恒第一次以Qwen負責人的身份公開亮相。字母榜對那場演講的概括是一句話:每一份算力換多少智能。他報的數字是,Qwen3.8-Flash對比Qwen3.7-Plus,激活參數減到1/3,訓練成本降到1/9。
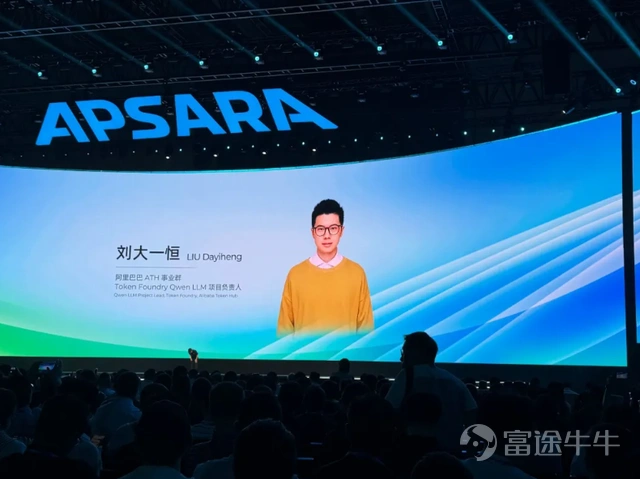
怎麼省的,寫在8月26日開源的Qwen3.8-Flash-Next模型卡上,阿里稱它是「Qwen4所用模型結構的先導預覽」。注意力每四層裏有三層換成Gated DeltaNet,殘差流從一條擴成4條,主模型之外另掛一張51B的Embedding查找表,優化器換成Muon。四處改動,都是在講怎麼省算力。
省下來的算力去了哪兒?
現役旗艦Qwen3.8-Max的總參數已經是2.4T,Qwen4.5、Qwen5要擴到5到10T。模型卡里還有一句話:「固定激活專家數量而持續增加專家總參數量,可穩定降低訓練loss。」
劉大一恒把每一分智能的成本壓下來,省出的錢全押在了規模上。
他自己的說法是,Max系列追求智能天花板,降低使用門檻是Flash、Plus的事。參數規模的擴展,仍是通向ASI的核心路徑之一。
Hy4的成績是擺在明面上的,姚順雨在模型圈的地位更是無需多言。
Hy4總參數770B,不到Qwen3.8-Max的三分之一。雖然在Artificial Analysis的榜單上,Hy4只比Qwen3.8-Max高1分,但每任務成本約0.78美元,是後者的13分之一。
騰訊這一年發了四個模型:4月Hy3 preview,7月Hy3,8月Hy4 preview,11月Hy4。
馬化騰在5月形容過自家的處境:「原來一年前我們以爲上了船,後來發現那個船漏水了,現在感覺站上去了,還坐不下去。」
BAT回來了。
02
張一鳴的10萬億模型去哪了?
正如前面說的,Seed2.1是6月23日發佈的。到11月12日,過去了142天。
這142天裏,騰訊、阿里、百度都有不小的動作,顯然這對於張一鳴來說還是有不小的壓力的。
其實年初那會不是這樣的。
2月那張LMArena榜單上,Seed 2.0還排在文心5.0前面。到了8月,有第三方榜單顯示,Seed2.1 Pro在全球大語言模型裏排第21位。字節CEO梁汝波在8月6日的年中全員會上承認,大語言模型和海外領先模型的差距有所拉大。
也是在8月上旬,10萬億的消息傳了出來。
外媒稱,字節正在預訓練一個參數規模最高可能達到10萬億的模型,仍處於早期階段,最終規模要到後續訓練階段才能確定。
在當時,國內公開披露的最大模型Kimi K3是2.8萬億參數,業內估計Anthropic的Mythos 5也就才8萬億。
有報道稱,這個項目完整的訓練週期預估爲3到6個月,最終是否對外發布沒有定論。從8月上旬算起,3個月是現在,6個月是明年2月。
也就是說,它眼下沒出現,還算不上遲到。
張一鳴還曾在全員會上表示,Seed大語言模型用的預訓練數據集,比頂尖對手小了幾個數量級。
DeepMind在2022年的Chinchilla論文裏給過一條經驗規律:參數翻倍,訓練數據也得跟着漲。參數可以堆,GPU可以買,字節今年5月就討論過把全年資本開支提到最高700億美元。
可唯獨數據不行。
外媒此前報道,張一鳴在Seed全員會上明確反對靠蒸餾外部模型來追趕,認爲字節應該願意「爲長期目標犧牲一些短期利益」。Seed內部還通過API檢測和訓練數據過濾,限制第三方模型的輸出進入訓練集。
不抄作業那自己就得好好補課了。
字節今年把分散在各條業務線的數據團隊收攏起來,成立了與Seed、Flow、抖音平行的一級部門「AI數據與安全」。
10月的時候,影視颶風的Tim,在內部交流中演示了字節跳動尚未官宣的世界模型。
這個模型是基於字節Seedance視頻生成體系打造的,支持老電影自由運鏡、虛擬場景實時交互、VR職業模擬等能力,主打雲端渲染的沉浸式空間體驗。
其實9月份那會外媒就曾披露,早已卸任字節日常運營的張一鳴,正親自跨部門協調研發、算力與硬件團隊,全程督導這款實時世界模型的訓練推進。
報道里寫到,這個項目被列爲字節年度最高優先級之一,目標是實現50毫秒延遲、每秒20幀的交互效果,未來將適配Pico VR與抖音內容生態。
字節今年在世界模型和Coding等方向的數據預算已經到了千萬美元級,還可以繼續追加。
不過字節的優勢還是不可撼動的,豆包仍是國內用戶規模最大的 AI 聊天應用,月活約3.24億。
張一鳴此前在內部會議上說,做模型要堅持長期主義、延遲滿足感,而不是用別人的輸出,換一時的榜單排名。
風險及免責聲明:以上內容僅代表作者個人觀點,不代表富途任何立場,亦不構成任何投資建議,富途對此不作任何保證與承諾。更多信息

評論
發表評論
3
1